Файл robots.txt для сайта: что это, как создать, настроить и проверить
Разбираем, как создать и настроить robots.txt, управлять обходом сайта поисковыми роботами и не закрыть от сканирования важные страницы.
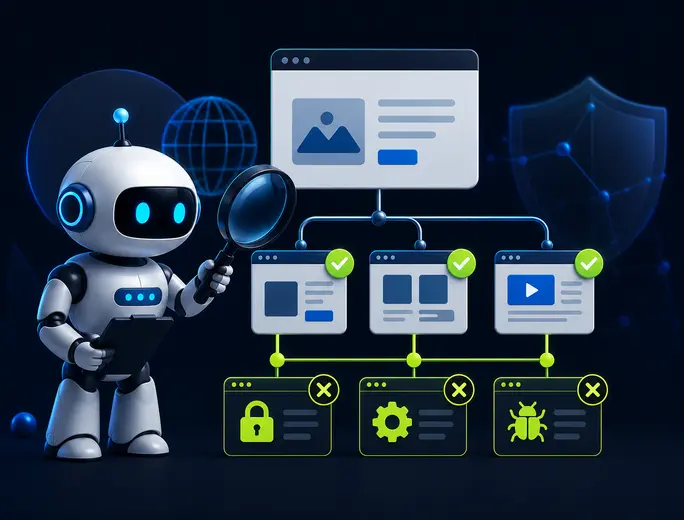
Robots.txt — небольшой текстовый файл, который сообщает поисковым роботам, какие страницы и разделы сайта им разрешено сканировать, а какие обходить не следует. С его помощью можно ограничить сканирование технических страниц, внутреннего поиска, URL с параметрами и других адресов, которые поисковым роботам не нужно регулярно обходить.
На первый взгляд настройка robots.txt кажется простой: достаточно добавить несколько строк User-agent и Disallow. На практике ошибка может закрыть от обхода важные страницы, категории товаров или даже весь сайт.
Корректный robots.txt составляют с учётом структуры конкретного проекта, CMS и задач SEO, а не копируют из универсального шаблона.
Разберёмся, для чего нужен robots.txt, где он находится, как его создать и проверить, какие директивы использовать и почему запрет сканирования не гарантирует удаление страницы из поиска.
Что такое robots.txt
Robots.txt — это текстовый файл с инструкциями для поисковых и других автоматизированных роботов.
Когда поисковый робот приходит на сайт, он может обратиться к robots.txt и определить, какие URL ему разрешено сканировать.
Например, с помощью файла можно сообщить роботу:
Google описывает robots.txt прежде всего как средство управления сканированием страниц и нагрузкой, которую робот создает на сервер. (developers.google.com)
Важно понимать: robots.txt не является системой безопасности. Некоторые роботы могут игнорировать его инструкции, поэтому конфиденциальные документы, персональные данные, административные интерфейсы и другую закрытую информацию нельзя защищать только через Disallow. Для таких материалов требуется настоящее ограничение доступа — например, авторизация или пароль. (developers.google.com)
Для чего нужен файл robots.txt
Основная задача robots.txt — управлять обходом сайта поисковыми роботами.
Файл особенно полезен, если сайт содержит много технических, повторяющихся или служебных URL.
Например:
Для небольшого корпоративного сайта из нескольких десятков страниц robots.txt обычно остаётся простым.
Для крупного интернет-магазина с десятками тысяч товаров, фильтрами, сортировками и параметрами URL настройка может быть гораздо сложнее.
При этом robots.txt не предназначен для гарантированного удаления страницы из поисковой выдачи. Он прежде всего регулирует возможность сканирования URL. Google отдельно предупреждает, что URL, закрытый в robots.txt, при определенных условиях все равно может появиться в результатах поиска. (developers.google.com)
Эту разницу между сканированием и индексированием мы подробно разберем ниже.
Нужен ли сайту robots.txt
Строго говоря, сайт может работать и без robots.txt. Если специальных ограничений для поисковых роботов нет, отсутствие файла само по себе не означает, что страницы сайта перестанут индексироваться.
Но на большинстве коммерческих сайтов robots.txt полезен.
Особенно он нужен, когда необходимо:
Поэтому важнее определить, нужно ли ограничивать обход отдельных страниц и разделов.
Где находится файл robots.txt
Файл robots.txt должен находиться в корневом каталоге сайта.
Проверить его обычно можно по адресу:
https://example.ru/robots.txt
То есть достаточно добавить /robots.txt после доменного имени.
Например:
https://site.ru/robots.txt
Яндекс также указывает, что файл должен называться именно robots.txt, располагаться в корне сайта и быть доступен роботу. Правила действуют только для того протокола, домена или поддомена и порта, где опубликован файл. (yandex.ru)
Как посмотреть robots.txt чужого сайта
Таким же способом можно проверить robots.txt другого сайта, если файл доступен публично.
Если интересующий сайт находится по адресу:
https://example.ru/
попробуйте открыть:
https://example.ru/robots.txt
Если файл существует и доступен, браузер покажет его содержимое как обычный текст.
Это удобно при анализе конкурентов, но копировать чужой robots.txt на свой сайт не следует: структура каталогов, CMS, фильтры и технические URL у проектов различаются.
Как создать файл robots.txt для сайта
Создать robots.txt можно в обычном текстовом редакторе. Сохраните его в UTF-8 и после загрузки убедитесь, что сервер отвечает кодом 200 OK. Google обрабатывает файл размером до 500 КиБ.
Базовый порядок действий выглядит так.
1. Создайте текстовый файл
Название должно быть:
robots.txt
Не:
robot.txt
robots.html
Robots.txt
robots.txt.html
а именно:
robots.txt
2. Добавьте правила
Простейший вариант, не содержащий запрета на обход страниц:
User-agent: *
Disallow:
Здесь User-agent: * означает, что правила относятся ко всем роботам, а пустой Disallow: не запрещает обход путей.
3. При необходимости добавьте Sitemap
Например:
User-agent: *
Disallow:

Sitemap: https://example.ru/sitemap.xml
4. Загрузите файл в корневой каталог
После размещения он должен открываться по адресу:
https://example.ru/robots.txt
5. Проверьте файл
Недостаточно убедиться, что robots.txt просто открывается в браузере. Необходимо проверить, какие именно URL разрешены или запрещены его правилами.
Для этого особенно удобно использовать инструменты поисковых систем. Например, в Яндекс Вебмастере есть отдельный инструмент анализа robots.txt с проверкой конкретных URL. (yandex.ru)
Основные директивы robots.txt
В robots.txt используются специальные команды — директивы.
Основные из них:
| Директива | Для чего используется |
|---|---|
User-agent |
Указывает робота, для которого действуют правила |
Disallow |
Ограничивает обход определенного пути |
Allow |
Разрешает обход определенного пути |
Sitemap |
Указывает адрес XML-карты сайта |
Clean-param |
Помогает Яндексу обрабатывать URL с незначащими GET-параметрами |
Яндекс в актуальной документации перечисляет User-agent, Disallow, Allow, Sitemap и Clean-param среди поддерживаемых директив. (yandex.ru)
В путях можно использовать * для любой последовательности символов и $ для обозначения конца URL. Текст после # считается комментарием. Пути чувствительны к регистру: /Catalog/ и /catalog/ — разные адреса.
Рассмотрим каждую подробнее.
User-agent в robots.txt
User-agent определяет, для какого поискового робота предназначены следующие правила.
Например:
User-agent: *
Символ * означает всех роботов.
Можно создать отдельную секцию для конкретного робота.
Например:
User-agent: Yandex
Disallow: /example/
Эти правила предназначены для робота Яндекса.
Для Googlebot конструкция может выглядеть так:
User-agent: Googlebot
Disallow: /example/
Во многих случаях достаточно общей секции:
User-agent: *
Но если поисковым системам требуется передать разные инструкции, можно использовать отдельные группы правил.
Важно: если для User-agent: Yandex создана отдельная группа, Яндекс использует её и не добавляет к ней правила из группы User-agent: *. Поэтому все необходимые ограничения для Яндекса нужно повторить в его группе.
Что значит Disallow в robots.txt
Disallow — одна из главных директив файла robots.txt.
Она используется для ограничения сканирования определенного пути.
Например:
User-agent: *
Disallow: /admin/
Такое правило запрещает роботам указанной группы сканировать URL, начинающиеся с /admin/.
Как запретить сканирование отдельной страницы
Например:
User-agent: *
Disallow: /temporary-page.html
Как закрыть целый раздел
User-agent: *
Disallow: /private/
Как закрыть весь сайт в robots.txt
Для этого используется:
User-agent: *
Disallow: /
Это очень важная конструкция.
На тестовом сайте подобная настройка иногда используется намеренно, но на рабочем проекте случайно оставленный Disallow: / закроет весь сайт для обхода указанными роботами.
Если возникли проблемы с обходом сайта, прежде всего проверьте, нет ли в robots.txt глобального запрета.
Как разрешить сканирование сайта
Если запреты не нужны, возможен такой вариант:
User-agent: *
Disallow:
Пустой Disallow: не задает запрещенный путь.
Также существует директива Allow.
Например:
User-agent: *
Disallow: /catalog/
Allow: /catalog/popular/
Путь /catalog/popular/ разрешён, потому что правило Allow более конкретное, чем Disallow: /catalog/. Расположение строк в файле на приоритет не влияет.
Allow полезен в случаях, когда нужно закрыть большой раздел, оставив доступ к отдельным страницам или подкаталогам.
Как запретить страницу в robots.txt
Если необходимо ограничить сканирование конкретной страницы, можно прописать ее путь:
User-agent: *
Disallow: /page.html
Если необходимо запретить раздел:
User-agent: *
Disallow: /section/
Если необходимо запретить несколько разделов:
User-agent: *

Disallow: /admin/
Disallow: /search/
Disallow: /tmp/
Но перед добавлением любого такого правила нужно проверить:
- действительно ли страницу не нужно сканировать;
- нет ли на ней полезного поискового контента;
- не находится ли внутри закрываемого каталога важный раздел;
- не требуется ли вместо robots.txt использовать
noindex, canonical или другой инструмент.
Именно на этом этапе чаще всего возникают SEO-ошибки.
Robots.txt и индексация: почему Disallow не равен Noindex
Один из самых распространенных вопросов — как закрыть страницу от индексации через robots.txt.
Здесь важно разделять два процесса:
Сканирование — поисковый робот загружает URL и изучает его содержимое.
Индексирование — поисковая система принимает решение о хранении информации о странице и возможности показывать ее в результатах поиска.
Disallow в robots.txt прежде всего ограничивает сканирование.
Это не то же самое, что команда:
«Никогда не показывай этот URL в результатах поиска».
Google прямо указывает, что заблокированный robots.txt URL все равно может появиться в поиске, например если поисковая система узнает о нем по ссылкам с других сайтов. При этом робот может не иметь возможности прочитать содержимое самой страницы. (developers.google.com)
Можно ли запретить индексацию через robots.txt
Использовать robots.txt как универсальный способ удаления страниц из индекса не стоит.
Если необходимо именно предотвратить появление HTML-страницы в поисковой выдаче, обычно используется директива noindex, например:
<meta name="robots" content="noindex">
Google поддерживает noindex через meta robots или HTTP-заголовок. (developers.google.com)
Но есть важный нюанс.
Если одновременно:
Disallow: /page/
закрывает роботу доступ к странице, а на самой странице установлен:
<meta name="robots" content="noindex">
робот не сможет открыть страницу и увидеть noindex.
Поэтому при работе с индексированием нужно понимать, какую задачу решает каждая директива.
Когда robots.txt подходит
Robots.txt подходит, когда нужно сказать:
«Не сканируй этот URL или раздел».
Когда нужен noindex
noindex используется, когда задача звучит:
«Не показывай эту страницу в поисковой выдаче».
Это принципиально разные сценарии.
Как добавить Sitemap в robots.txt
В robots.txt можно указать адрес XML-карты сайта.
Пример:
Sitemap: https://example.ru/sitemap.xml
Полный минимальный вариант может выглядеть так:
User-agent: *
Disallow:

Sitemap: https://example.ru/sitemap.xml
Яндекс поддерживает директиву Sitemap в robots.txt. (yandex.ru)
Robots.txt и Sitemap — одно и то же?
Нет.
Robots.txt сообщает роботам правила обхода URL.
Sitemap.xml содержит информацию о страницах сайта, которые поисковой системе полезно обнаружить.
То есть один файл не заменяет другой.
Сайт может одновременно иметь:
https://example.ru/robots.txt
и:
https://example.ru/sitemap.xml
Это нормальная и распространенная конфигурация.
Clean-param в robots.txt для Яндекса
Отдельного внимания заслуживает директива Clean-param.
Она используется Яндексом для работы с URL, содержащими GET-параметры, которые не меняют значимое содержимое страницы.
Допустим, один и тот же материал доступен по URL:
https://example.ru/product/?ref=site1
https://example.ru/product/?ref=site2
https://example.ru/product/?ref=site3
Если параметр ref используется только для аналитики и не меняет страницу, Яндексу можно сообщить, что его не нужно учитывать.
Например:
User-agent: Yandex
Clean-param: ref /product/
Синтаксис позволяет перечислять несколько параметров через &:
Clean-param: parameter1¶meter2 /path/
А если путь не указан, правило может применяться ко всему сайту. Актуальная документация Яндекса описывает именно такой синтаксис Clean-param. (yandex.ru)
Нужно ли прописывать UTM-метки через Clean-param
Не всегда.
Яндекс сообщает, что некоторые распространенные аналитические параметры, включая ряд utm_*, могут распознаваться автоматически как незначащие. Поэтому без необходимости добавлять длинный перечень стандартных UTM-параметров в robots.txt не следует. (yandex.ru)
Clean-param особенно полезен, когда конкретная CMS или функциональность сайта создает собственные параметры, которые приводят к появлению множества дублей одного содержимого.
Перед применением директивы необходимо убедиться, что параметр действительно не влияет на контент страницы.
Пример файла robots.txt
Универсального «правильного robots.txt», который подходит каждому сайту, не существует.
Но можно рассмотреть несколько простых примеров.
Пример 1. Простой robots.txt
User-agent: *
Disallow:

Sitemap: https://example.ru/sitemap.xml
Такой вариант не устанавливает запрещенных путей и сообщает адрес Sitemap.
Пример 2. Robots.txt с закрытыми техническими разделами
User-agent: *

Disallow: /admin/
Disallow: /search/
Disallow: /tmp/

Sitemap: https://example.ru/sitemap.xml
Важно: названия каталогов здесь условные.
Нельзя просто копировать этот пример на свой сайт и предполагать, что /search/, /tmp/ или любой другой каталог действительно нужно закрыть.
Пример 3. Отдельные правила для Яндекса
User-agent: *

Disallow: /admin/
Disallow: /search/

Sitemap: https://example.ru/sitemap.xml

User-agent: Yandex
Disallow: /admin/
Disallow: /search/
Clean-param: ref
Конкретная конфигурация зависит от структуры сайта.
Правила для Яндекса продублированы намеренно: отдельная группа User-agent: Yandex не наследует ограничения из группы User-agent: *.
Как составить правильный robots.txt
Сначала изучите структуру URL, а затем составляйте список директив.
Алгоритм может выглядеть так.
Шаг 1. Соберите основные типы страниц
Например:
Шаг 2. Определите, какие URL должны сканироваться
Коммерческие посадочные страницы, категории, товары, услуги и информационные материалы обычно должны оставаться доступными поисковым роботам, если вы рассчитываете получать по ним поисковый трафик.
Шаг 3. Найдите технические URL
Необходимо понять, какие адреса создаются CMS, фильтрами, сортировками, поиском и другими компонентами сайта.
Шаг 4. Выберите подходящий инструмент
Не каждый ненужный URL нужно закрывать именно robots.txt.
В зависимости от задачи могут использоваться:
Disallow;noindex;- canonical;
- редирект;
- удаление страницы;
- изменение внутренней перелинковки;
- изменение логики генерации URL;
Clean-param.
Шаг 5. Проверьте результат
После изменения robots.txt обязательно проверьте несколько реальных URL каждого типа.
Проверка реальных URL надёжнее визуального просмотра файла.
Как проверить robots.txt
Проверка robots.txt состоит из нескольких этапов.
1. Откройте файл в браузере
Введите:
https://example.ru/robots.txt
Убедитесь, что файл доступен.
Для Яндекса среди требований к robots.txt указаны размещение в корне сайта и доступность файла для робота. (yandex.ru)
2. Проверьте, не закрыт ли весь сайт
Ищите конструкцию:
User-agent: *
Disallow: /
Если сайт рабочий и должен получать поисковый трафик, наличие такого правила требует особого внимания.
3. Проверьте важные разделы
Например:
/catalog/
/services/
/blog/
/product/
Убедитесь, что более широкое правило случайно не запрещает нужные URL.
4. Проверьте Sitemap
Если в robots.txt присутствует:
Sitemap: ...
убедитесь, что указан актуальный адрес карты сайта.
5. Проверьте robots.txt в Яндекс Вебмастере
В Яндекс Вебмастере доступен инструмент:
Инструменты → Анализ robots.txt.
Он позволяет анализировать содержимое файла и проверять, разрешены ли конкретные URL для робота Яндекса. (yandex.ru)
Это особенно удобно после изменения сложных правил Allow и Disallow.
6. Проверяйте реальные URL, а не только синтаксис
Файл может выглядеть правильно, но давать неожиданный результат на конкретной структуре сайта.
Поэтому проверяйте адреса:
- главной страницы;
- категории;
- карточки товара;
- статьи;
- технической страницы;
- страницы фильтра;
- URL с параметром.
Проверка robots.txt онлайн
В интернете существует множество сторонних анализаторов и генераторов robots.txt.
Они помогают проверить синтаксис или создать начальный шаблон, но сгенерированный файл нельзя загружать на сайт без проверки.
Сервис не знает:
- какие страницы приносят вам поисковый трафик;
- какие фильтры являются посадочными;
- какие параметры меняют содержимое;
- какие URL должны индексироваться;
- какие технические разделы используются вашей CMS.
Поэтому онлайн-генератор robots.txt лучше рассматривать как вспомогательный инструмент, а не как замену анализа сайта.
Если сайт содержит фильтры, параметры или много технических URL, безопаснее сначала провести технический SEO-аудит, а затем менять robots.txt.
Robots.txt для Яндекса
Для Яндекса можно использовать общую секцию:
User-agent: *
или отдельную:
User-agent: Yandex
Яндекс поддерживает стандартные директивы управления обходом, а также собственную директиву Clean-param. (yandex.ru)
Проверка robots.txt в Яндекс Вебмастере
Для владельцев сайтов это один из наиболее удобных способов проверить файл.
Инструмент анализа позволяет увидеть, как робот Яндекса интерпретирует правила, и протестировать конкретные адреса. (yandex.ru)
Особенно полезно выполнять проверку после:
- изменения структуры сайта;
- запуска новых фильтров;
- переноса сайта;
- изменения CMS;
- редактирования robots.txt;
- появления проблем с обходом страниц.
Нужна ли директива Host в robots.txt
В старых статьях по SEO можно встретить:
Host: example.ru
Раньше эта директива применялась в Яндексе для работы с главным зеркалом сайта.
Сейчас добавлять Host в robots.txt не требуется.
Яндекс еще в 2018 году сообщил, что 301-редирект полностью заменил директиву Host при выборе главного зеркала и эту строку можно удалить из robots.txt. (webmaster.yandex.ru)
Поэтому современные шаблоны, содержащие обязательную строку Host, стоит воспринимать как устаревшие.
Это хороший пример того, почему не стоит скачивать robots.txt из старой статьи и устанавливать его без проверки.
Robots.txt для WordPress
У WordPress есть собственная логика работы с robots.txt.
WordPress способен динамически формировать содержимое robots.txt, включая базовые правила для /wp-admin/. В официальной документации WordPress предусмотрены функции и фильтры для изменения генерируемого содержимого. (developer.wordpress.org)
Но это не означает, что для любого WordPress-сайта существует один идеальный шаблон.
Настройки интернет-магазина на WooCommerce, корпоративного сайта и информационного блога могут существенно различаться.
При SEO-аудите сайта на WordPress нужно проверять не только robots.txt, но и:
- структуру рубрик;
- теги;
- поиск;
- пагинацию;
- архивы;
- параметры WooCommerce;
- фильтры товаров;
- работу SEO-плагинов;
- фактическую структуру URL.
Не стоит закрывать системные разделы только потому, что такие запреты встречаются в чужом robots.txt.
Robots.txt в Tilda
На сайтах Tilda файлы robots.txt и sitemap.xml генерируются платформой автоматически. В справочном центре Tilda указано, что посмотреть их можно стандартным способом, добавив /robots.txt или /sitemap.xml к адресу сайта. (help-ru.tilda.cc)
Например:
https://example.ru/robots.txt
Если сайт находится на Tilda, прежде чем вручную создавать или заменять файл, проверьте встроенные SEO-настройки платформы и текущий robots.txt опубликованного сайта.
Отдельное внимание требуется при запрете индексации тестового или незавершенного проекта. Tilda рекомендует для действительно закрытого доступа использовать ограничения вроде логина и пароля, а не полагаться исключительно на поисковые настройки. (help-ru.tilda.cc)
Robots.txt в 1С-Битрикс
В современных версиях модуля SEO в 1С-Битрикс предусмотрено управление robots.txt через специальный инструмент.
Официальная документация указывает путь:
Маркетинг → Поисковая оптимизация → Настройка robots.txt. (dev.1c-bitrix.ru)
Это удобнее ручного редактирования, но логика остается прежней: перед настройкой необходимо определить, какие типы страниц должны быть доступны поисковым системам.
Особенно внимательно следует относиться к интернет-магазинам на Битрикс, где могут присутствовать:
- фильтры;
- сортировки;
- параметры;
- результаты поиска;
- служебные страницы;
- различные варианты URL каталога.
Готовый robots.txt другого магазина не обязательно подойдет вашему проекту.
Можно ли скачать готовый файл robots.txt
Скачать готовый файл можно, но использовать его без проверки опасно.
Robots.txt содержит пути, характерные для конкретного сайта.
Например:
Disallow: /catalog/filter/
может быть разумным на одном проекте и ошибочным на другом, где /catalog/filter/ содержит специально созданные SEO-посадочные страницы.
То же касается WordPress, Битрикс, самописных CMS и других платформ.
Поэтому безопаснее не скачивать готовый robots.txt, а взять пример за основу и адаптировать его под структуру своего сайта.
Частые ошибки в robots.txt
1. Закрыт весь сайт
User-agent: *
Disallow: /
Одна лишняя косая черта способна полностью изменить смысл файла.
Особенно часто такая проблема возникает после переноса настроек с тестовой версии сайта.
2. Закрыты важные коммерческие страницы
Например, правило для /catalog/ может случайно закрыть весь товарный каталог.
Перед добавлением Disallow всегда нужно проверять реальные URL.
3. Robots.txt используется вместо noindex
Это одна из самых распространенных концептуальных ошибок.
Disallow управляет сканированием и не является гарантией удаления URL из поиска. Google отдельно предупреждает об этом. (developers.google.com)
4. Закрыты необходимые CSS и JavaScript
Если поисковый робот не может получить необходимые ресурсы страницы, ему может быть сложнее корректно обработать ее содержимое. Google рекомендует не блокировать ресурсы, если это мешает интерпретации страницы. (developers.google.com)
5. Скопирован файл другого сайта
Даже сайты на одной CMS могут иметь совершенно разную структуру.
Копирование robots.txt конкурента не заменяет анализ структуры собственного сайта.
6. Используется устаревшая директива Host
Для Яндекса она больше не нужна; предпочтение отдается корректной настройке зеркал и редиректов. (webmaster.yandex.ru)
7. Неправильно указан Sitemap
Всегда проверяйте, что адрес Sitemap действительно открывается и относится к нужному сайту.
8. Без необходимости закрываются URL с параметрами
Не каждый URL с ? является дублем.
Иногда параметр действительно меняет содержимое страницы. Поэтому сначала нужно определить назначение параметра и только потом решать, нужен ли Disallow, Clean-param, canonical или другое решение.
9. Изменения не проверяются на конкретных URL
Даже небольшое изменение шаблона может затронуть тысячи страниц.
После редактирования robots.txt необходимо тестировать реальные адреса.
Влияет ли robots.txt на SEO
Сам по себе robots.txt не повышает позиции сайта.
Он помогает управлять обходом сайта и расходованием краулинговых ресурсов.
На крупных проектах корректная настройка помогает поисковым роботам не тратить ресурсы на большое количество технических и повторяющихся URL.
Но robots.txt нельзя рассматривать изолированно.
При технической оптимизации вместе с ним обычно анализируются:
- индексирование страниц;
- XML Sitemap;
- canonical;
- meta robots;
- HTTP-коды;
- редиректы;
- дубли;
- параметры URL;
- пагинация;
- внутренняя перелинковка;
- структура сайта.
Эти настройки определяют, какие страницы поисковая система обнаружит, сможет проиндексировать и показывать в поиске. Настройка robots.txt — лишь одна из задач SEO-продвижения сайта.
Когда стоит проверить robots.txt
Проверка особенно важна, если:
В этих случаях проверьте не только файл, но и связанные с ним настройки индексирования.
Частые вопросы о robots.txt
Для чего нужен robots.txt?
Основная задача — управление сканированием URL поисковыми роботами. С его помощью можно ограничивать обход отдельных страниц и разделов, а также указывать Sitemap.
Как найти robots.txt сайта?
Добавьте /robots.txt после доменного имени и откройте адрес в браузере.
Как создать robots.txt?
Создайте текстовый файл с названием robots.txt, добавьте необходимые директивы, разместите его в корне сайта и проверьте доступность и применение правил.
Что значит Disallow в robots.txt?
Disallow задает путь, сканирование которого ограничивается для указанного робота.
Пример:
User-agent: *
Disallow: /admin/
Как разрешить весь сайт в robots.txt?
Один из простых вариантов:
User-agent: *
Disallow:
Как закрыть весь сайт в robots.txt?
User-agent: *
Disallow: /
На рабочем сайте использовать такую конструкцию нужно крайне осторожно.
Как запретить одну страницу?
Например:
User-agent: *
Disallow: /private-page/
Можно ли закрыть страницу от индексации через robots.txt?
Robots.txt не является надежным инструментом для гарантированного исключения URL из поисковой выдачи. Он прежде всего регулирует сканирование. Для управления индексированием применяются другие механизмы, например noindex. (developers.google.com)
Нужно ли добавлять Sitemap в robots.txt?
Это распространенный и поддерживаемый способ сообщить поисковому роботу расположение Sitemap. (yandex.ru)
Что такое Clean-param?
Это поддерживаемая Яндексом директива для URL с GET-параметрами, которые не влияют на значимое содержимое страницы. Она помогает роботу не обрабатывать множество вариантов одного и того же URL как самостоятельные страницы. (yandex.ru)
Нужен ли Host в robots.txt?
Нет. Для Яндекса эта директива устарела: ее функции при выборе главного зеркала были заменены использованием редиректов. (webmaster.yandex.ru)
Как проверить robots.txt?
Начните с открытия /robots.txt, затем проверьте важные URL и воспользуйтесь инструментами поисковых систем. В Яндекс Вебмастере для этого предусмотрен раздел «Анализ robots.txt». (yandex.ru)
Главное о файле robots.txt
Robots.txt влияет на то, какие URL смогут обходить поисковые роботы.
Главное, что нужно запомнить:
- файл называется
robots.txt; - он располагается в корне сайта;
User-agentопределяет робота;Disallowограничивает сканирование;Allowпозволяет создать разрешающее правило;Sitemapсообщает адрес карты сайта;Clean-paramприменяется Яндексом для работы с определенными параметрическими URL;Disallowиnoindexрешают разные задачи;- директива
Hostдля Яндекса больше не требуется; - универсального robots.txt для всех сайтов не существует;
- после любых изменений файл необходимо проверять на реальных URL.
Для небольшого сайта настройка может занимать несколько строк. Для интернет-магазина, маркетплейса или крупного информационного проекта robots.txt становится частью более сложной системы технического SEO.
Если на сайте есть проблемы с индексированием, большое количество дублей, фильтров и параметрических страниц или вы не уверены, какие разделы следует открывать и закрывать для поисковых роботов, одного редактирования robots.txt может быть недостаточно.
В такой ситуации стоит провести технический SEO-аудит сайта: проверить robots.txt вместе с Sitemap, индексированием, canonical, редиректами, дублями и внутренней перелинковкой.
Комплексная проверка помогает найти не только ошибку в robots.txt, но и связанные проблемы индексирования. Не уверены, какие страницы можно закрывать от обхода? Закажите аудит — мы найдём ошибки и покажем, какие URL могут терять поисковый трафик.
Поделиться
Сохраните материал или отправьте его команде.